Der CLEW Agent ist ein KI-System, das für die Snowboard-Marke CLEW zu jedem eingehenden Zendesk-Ticket einen Antwortentwurf schreibt, den ein Mensch gegenliest und sendet. Er sucht Bestellungen in zwei Shopify-Shops, zieht Wissen aus Helpdesk und Support-Makros und hält sich an 24 feste Regeln. Ich habe Architektur, Pipeline und Betrieb entwickelt.
Warum CLEW einen neuen Support-Agenten brauchte
CLEW ist eine Snowboard-Marke mit zwei Shopify-Shops, einem für Europa und einem für die USA und Kanada, dazu einem eigenen Helpdesk. Support-Tickets zu Bindungen, Ersatzteilen, Lieferungen und Garantie laufen über Zendesk ein. Ein Vorgängersystem hatte keine Grenze für Modellaufrufe und keine festen Regeln für die Antworten. Viele Regeln im CLEW Agent gehen auf Fehler zurück, die dort dokumentiert wurden.
Ich habe den Agenten von der Architektur bis zum Betrieb gebaut. Die wichtigste Entscheidung stand zuerst fest: Der Agent sendet nie selbst. Er schreibt zu jedem eingehenden Ticket einen Antwortentwurf als interne Notiz in Zendesk, ein Mensch liest gegen und schickt ab. Das ist im Code erzwungen, nicht nur vereinbart: Der Zendesk-Client hat schlicht keine Methode, die öffentlich antwortet.
Wie der Agent zu einem Entwurf kommt
Der Webhook aus Zendesk trägt nur die Ticketnummer, den Rest holt sich der Agent über die API. Das läuft in sieben festen Schritten, höchstens drei davon mit einem Sprachmodell.
| Schritt | Was passiert |
|---|---|
| Rauschfilter | Spam und Autoantworten raus, ohne Modellaufruf |
| Kontext holen | Zendesk-Verlauf und beide Shopify-Shops, parallel |
| Klassifizieren | ein Modellaufruf, liefert Kategorie, Sprache, Bauteil, Bestellnummer |
| Entscheiden | Garantie, Eskalation, Händler-Routing, wieder ohne Modell |
| Entwurf schreiben | zweiter Modellaufruf, mit Wissen aus Helpdesk, Katalog und Makros |
| Guardrails | 24 feste Regeln prüfen den Text, in Code |
| Korrektur oder Vorlage | ein dritter Versuch, sonst eine handgeschriebene Vorlage |
Am Ende steht eine interne Notiz in Zendesk, dazu vorbefüllte Ticketfelder: Bestellnummer, Name, Adresse, Sendungsnummer, Thematik. Nur leere Felder werden gefüllt, die Eingabe einer Kollegin oder eines Kollegen wird nie überschrieben.
- Rauschfilter
- Kontext holen
- Klassifizieren
- Entscheiden
- Entwurf schreiben
- 24 Guardrails
- Korrektur oder Vorlage
interne Notiz
max. 3 Modellaufrufe
Wissen aus Helpdesk, Katalog und echten Antworten
Die Wissensbasis liegt in Postgres mit pgvector, aufgeteilt in zwei Namensräume: öffentliches Wissen, also Helpdesk-Artikel und Produktkatalog, und interne Support-Makros, die nie im Kundenkontext landen dürfen. Das Helpdesk wird gecrawlt statt über die offizielle API gelesen, weil die API bei einem Teil der Artikel nur ein leeres HTML-Gerüst liefert, ausgerechnet bei den Reparaturanleitungen für Straps und Bindungen.
Pro Entwurf sucht der Agent dreimal statt einmal, mit eigenen reservierten Plätzen für Makros, Helpdesk-Artikel und Produkte. Vorher konkurrierte eine Frage zur Garantie mit dem Produktkatalog um dieselben Plätze und verlor, einfach weil es deutlich mehr Produkt-Chunks als Artikel gibt.
Ein gemessenes statt ein vermutetes Embedding-Modell
Sechs Kandidaten wurden gegen zwanzig echte Fragen aus dem CLEW-Helpdesk getestet, überwiegend deutsche Fragen gegen englische Artikel. Gewählt wurde text-embedding-3-large, gekürzt auf 1024 Dimensionen. Das bisher genutzte Modell landete im Test auf dem letzten Platz.
Guardrails: was der Agent nie tut
24 harte Regeln prüfen jeden Entwurf, jede mit einem eigenen Test, mehrere direkt aus einem dokumentierten Fehlverhalten des Vorgängers abgeleitet. Der Agent verspricht nie kostenlosen Ersatz oder eine Erstattung, kündigt nie eine Übergabe an, unterschreibt nie mit dem Namen einer Kollegin oder eines Kollegen und weicht bei festen Fakten wie dem Rückgabefenster nicht vom hinterlegten Wert ab. Schlägt eine Prüfung an, bekommt das Modell genau einen Korrekturversuch, danach übernimmt eine handgeschriebene Vorlage.
Auch ein Chat für den Shop
Dieselbe Architektur trägt einen öffentlichen Chat-Widget für die Shopify-Storefront, eingebunden über ein einziges Skript-Tag. Das Aussehen kommt nicht aus einem eigenen Designsystem, sondern direkt aus den Theme-Variablen des Shops: eckige Kanten, keine Schatten, eine Schrift, kein fremdes CDN.
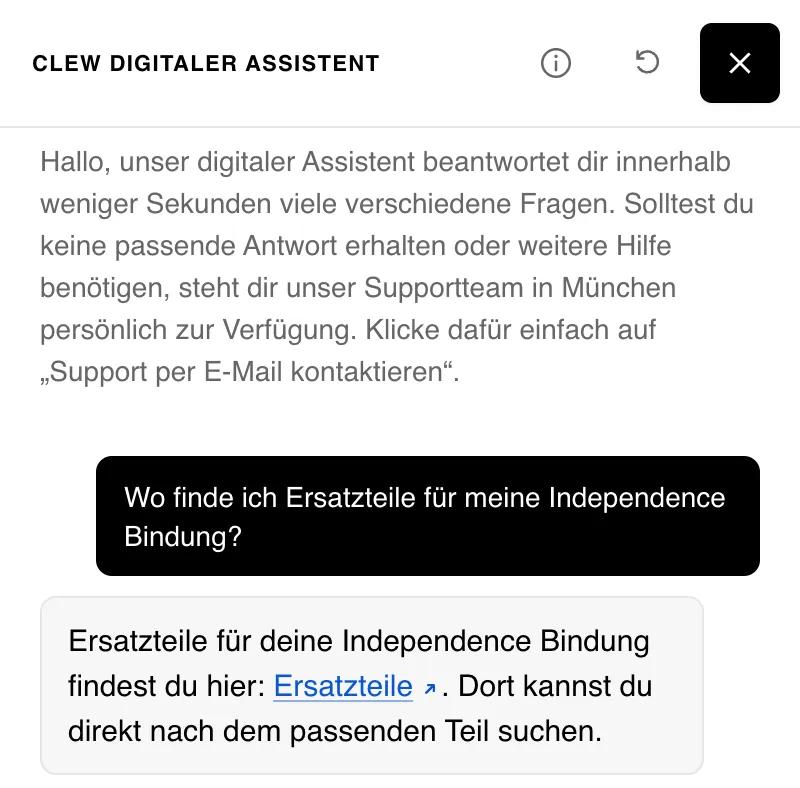
Eine Bestellung wird erst sichtbar, wenn Bestellnummer und Lieferadresse gemeinsam gegen den Shop bestätigt sind, geprüft im Code, bevor überhaupt ein Prompt gebaut wird. Ohne bestandene Prüfung existiert die Bestellung für das Modell schlicht nicht, keine Formulierung im Chat kann daran etwas ändern. Kommt der Bot nicht weiter, legt er ein Ticket als interne Notiz an statt öffentlich zu antworten, damit keine automatische Mail an eine womöglich falsch verstandene Adresse geht.
Architektur und Stack
TypeScript auf Node 22 im Strip-only-Modus, also ohne Build-Schritt. Hono als Webserver, das Vercel AI SDK mit OpenRouter für die Modellaufrufe, Postgres mit pgvector über Mastra, aber bewusst nur als dünne Schicht: Mastra hält die Datenbankverbindung und das Gedächtnis, trifft aber keine einzige Entscheidung der Pipeline selbst. Betrieb auf Railway, Deploy über GitHub, der Branch main ist geschützt, jede Änderung läuft über einen Pull Request.
Das Modellprofil lässt sich über eine einzige Variable tauschen, ohne Codeänderung: ein Profil für ein Frontier-Modell, eines nur mit Anbietern innerhalb der EU für strengere Datenschutzanforderungen, eines für ein selbst gehostetes Modell.
Gemessen statt behauptet
Gegen ein golden set aus 2142 echten, anonymisierten Fällen erreicht der Agent 99,7 Prozent korrekt erkanntes Rauschen, 84,2 Prozent Eskalationsentscheidungen wie ein Mensch, 98,3 Prozent korrekte Antwortsprache und null Entwürfe mit Regelverstoß. Der Rauschfilter allein erreicht 100 Prozent Präzision.
Was ich beim Bauen gelernt habe
Ein Mock beweist nur, dass Code und Mock derselben Meinung sind. Ein handgeschriebener Test nahm an, eine Bestellnummer trage eine Raute voran, der echte Shop liefert sie ohne. Hunderte grüne Tests verdeckten das, bis ein echter Fall es zeigte. Seitdem stammen die Fixtures aus echten, anonymisierten Antworten mit einem eigenen Redaktionsschritt.
Eine erzwungene Grenze schlägt eine dokumentierte Regel. Die alte Drei-Aufrufe-Regel stand nur in einer Notiz. Jetzt sitzt sie in einer einzigen Funktion, die jeden Modellaufruf umschließt, ein Aufruf über der Grenze erreicht den Anbieter gar nicht erst.
Ein Rauschfilter zahlt sich am stärksten aus, wenn er zuerst läuft. Er kostet keinen Modellaufruf und hätte allein beim Vorgänger hunderte unnötige Läufe verhindert.
Stand und Zugriff
Der CLEW Agent läuft seit Ende August 2026 produktiv und schreibt Entwürfe zu echten Zendesk-Tickets von CLEW. Das System ist ein internes Werkzeug ohne eigene öffentliche Oberfläche. Sichtbar wird es nur indirekt, in den Antworten des Supportteams.
Fragen zum Projekt oder ein ähnliches Vorhaben für dein Unternehmen? Schreib mir an kontakt@bitzer-fabian.de.